DeepSeek-V4.1-Flash模型下载及本地部署教程
一、性能及下载
DeepSeek-V4.1-Flash-1017 正式开源发布!比上一版本更强的基准性能、更快的任务完成速度,以及更短的输出——性能和成本的帕累托改进。现在已在我们的网站、应用和 API 上线。

DeepSeek-V4.1-Flash-20261017 (Max) 现已成为 Code Arena: WebDev 中排名第一的开源模型,超越了 Kimi K3 (Max),且成本仅为其十分之一!
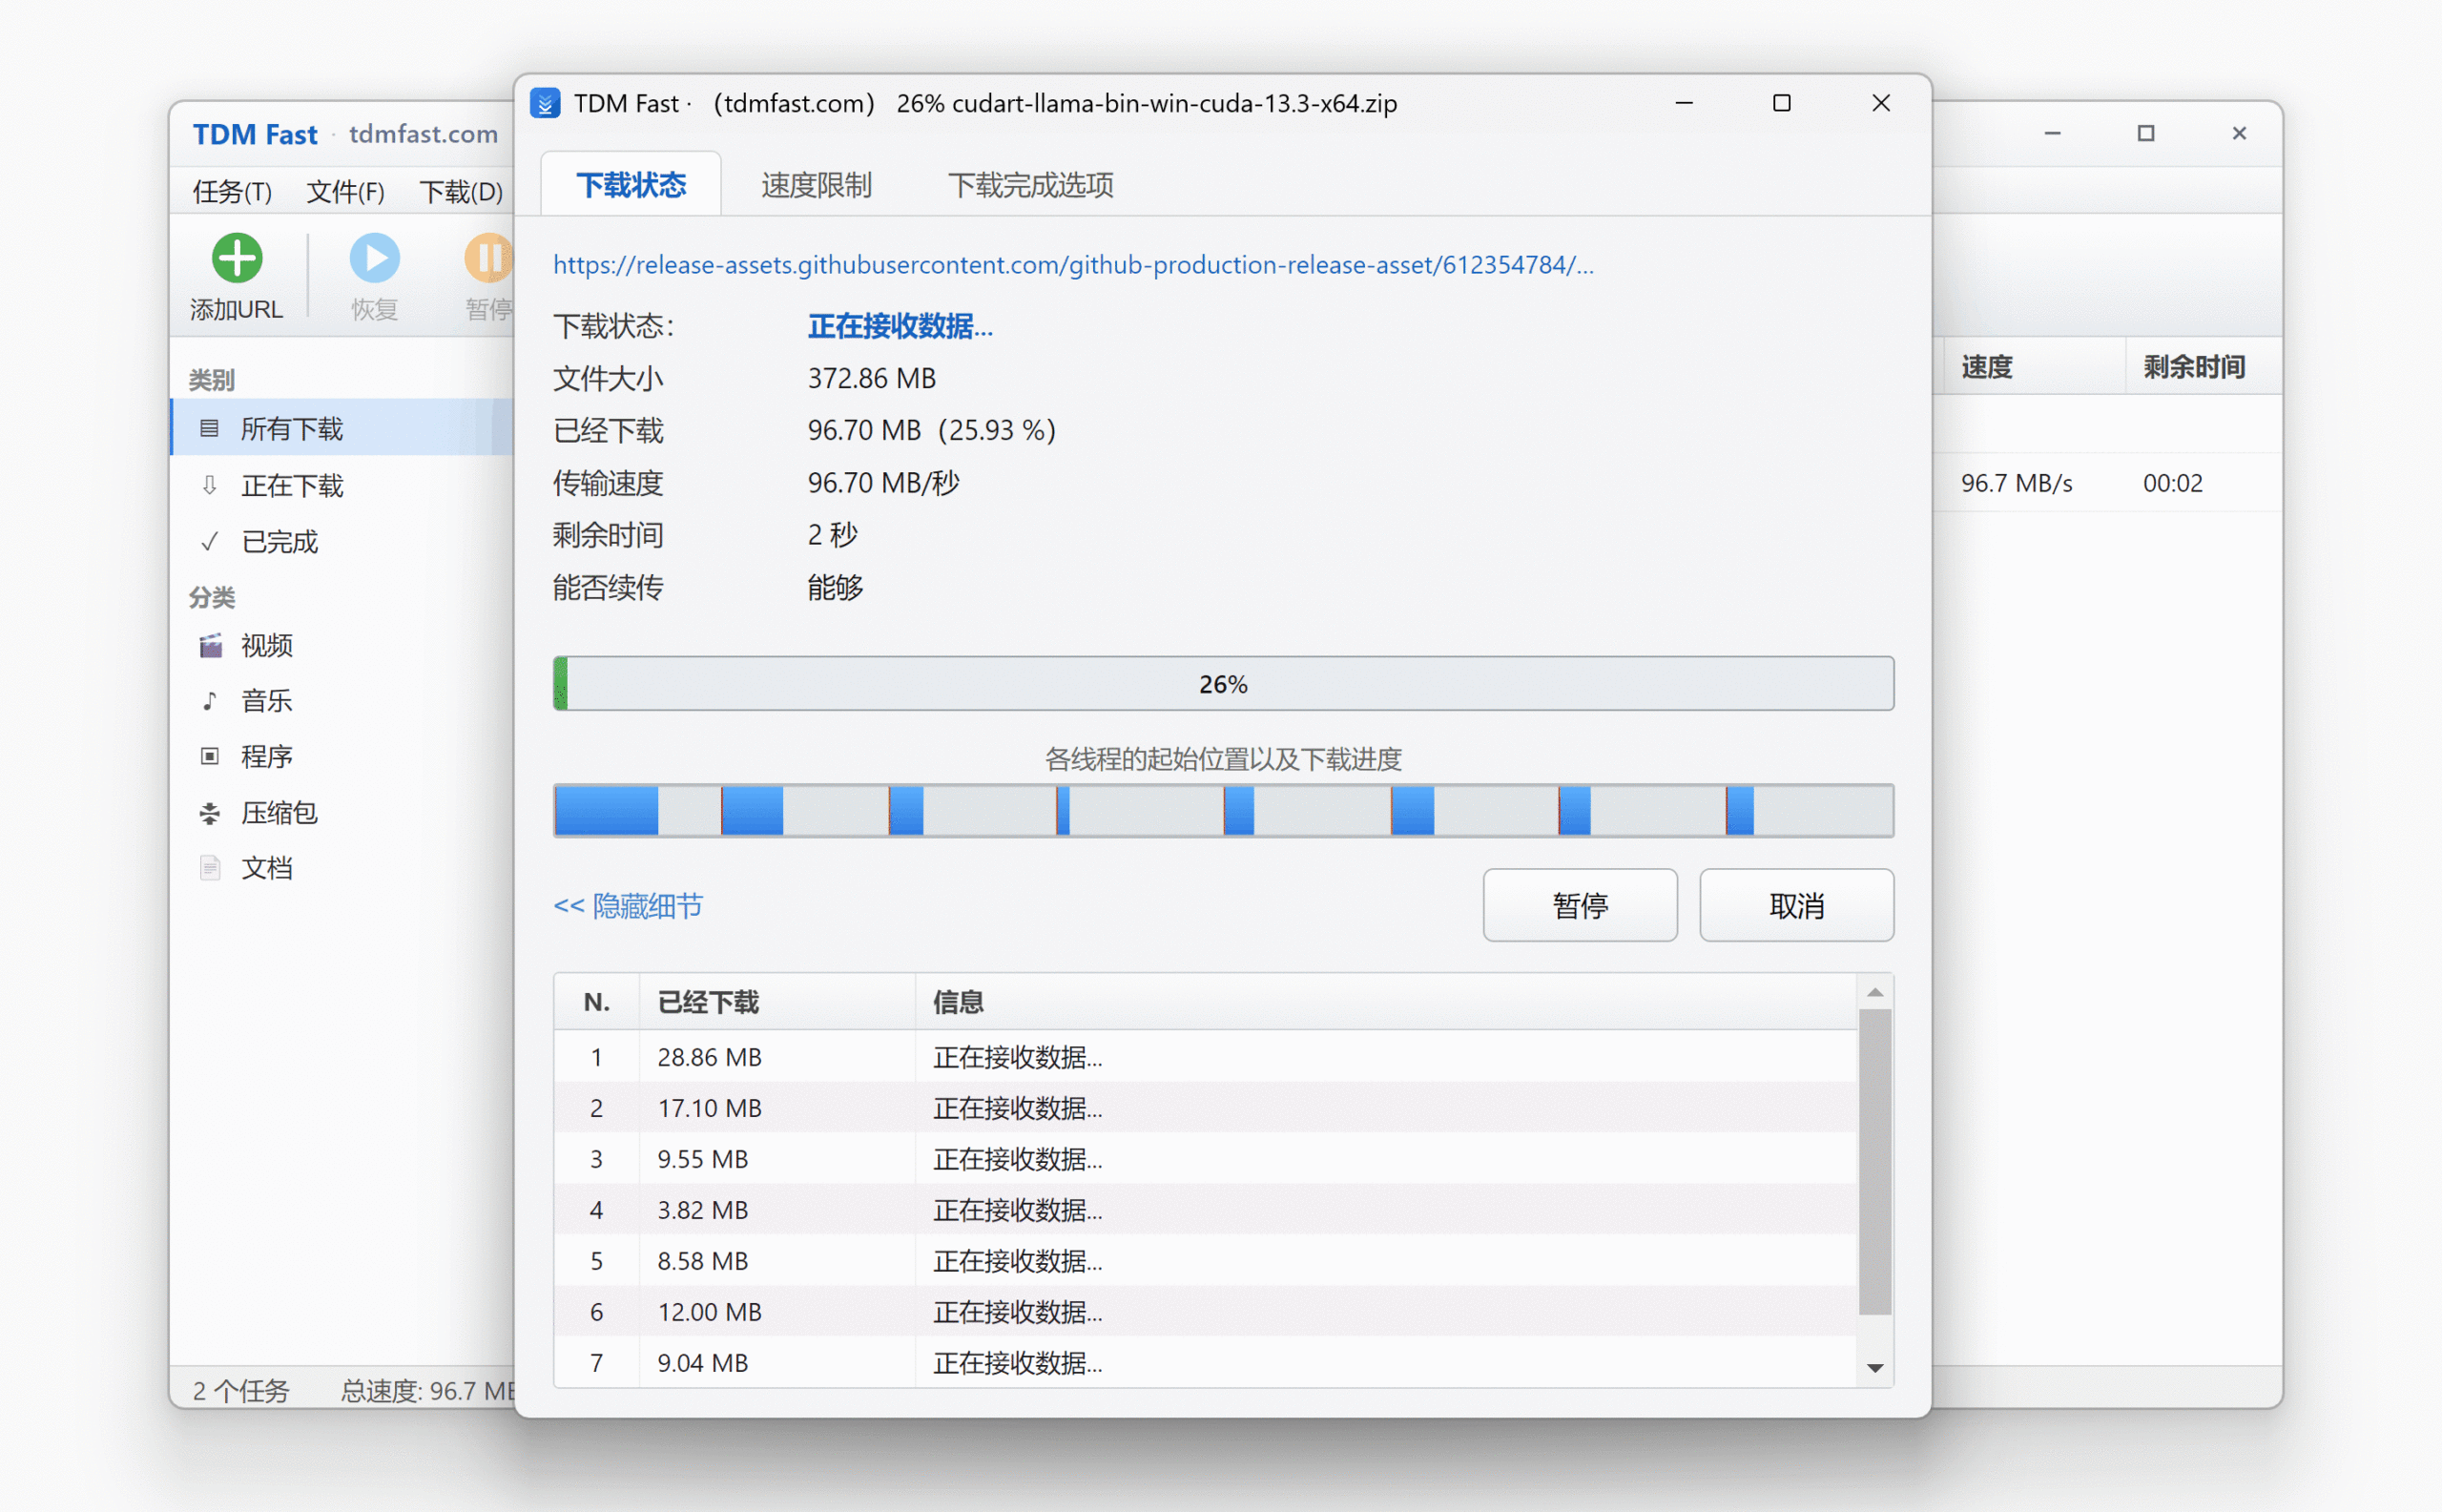
TDM Fast 高速下载器:【点击下载】

亮点:第一开源模型,领先于 Kimi K3 (Max) – 总排名第 12,1670 分,

领先于 Claude Opus 5 (High),与 GPT-6 Sol (Max) 的差距仅约 10 分 – 将帕累托前沿推移至每百万输入/输出令牌 $0.3/$1.2 – 比之前的 DeepSeek-V4.1-Flash-20260910 提升了 +52 分

DeepSeek-V4.1-Flash 下载
1、官方满血版:【点击前往】 或 【备用下载】
满血版大小总共是510G,对现存和硬件要求极高,没有足够的现存你可以用内存来硬抗,但现在的内存也不好买,当然你可以将其下载作为收藏!说不定将来会用到,毕竟这是目前最强的开源模型了!

2、GGUF 量化版
目前gguf格式的量化版主要有两个,分别是UD-Q4_K_XL 和 UD-Q8_K_XL ,当然体积也不小,分别是501G、508G,跟官方原版几乎没多少差距,但是贵在gguf格式,本地加载比较方便,你可以通过vLLM、Llama.cpp等方式进行本地加载运行!
TDM Fast 高速下载器:【点击下载】

二、本地部署
首先需要声明下,DeepSeek-V4.1-Flash-1017 本地部署对硬件要求比较高,显存或内存至少500G以上,哪怕是目前最新的量化版,也不能低于这个要求;满足以上条件,那么你就可以本地部署使用了,比如可以通过 vLLM、Llama.cpp 来进行本地加载模型!这次我们同样使用Llama.cpp来进行部署。
Llama.cpp 下载:【点击前往】
或使用一键安装包,内含驱动和一键启动脚本: 【点击下载】、【网盘下载】
下载解压后,在根目录下创建一个models 文件夹,然后将上面下载的9个模型分卷全部放进去,然后通过零度提供的一键启动脚本,双击运行后,启动后会自动识别模型!
三、一键启动脚本
【点击下载】
下载一键启动脚本解压后,将其解压并放入llama.cpp的根目录下,运行启动.bat脚本即可!就可以正常加载模型。

四、对接 API
当然无论你是本地模型,还是使用官方的API,我们都可以在 Deepseek Harness 上进行对接使用!
Deepseek Harness下载: 【点击前往】

lama.cpp 启动内置的本地 API 服务默认地址:http://127.0.0.1:8080/v1 密码:随便输入即可,比如12345678
评论